ReceiptLab
Description
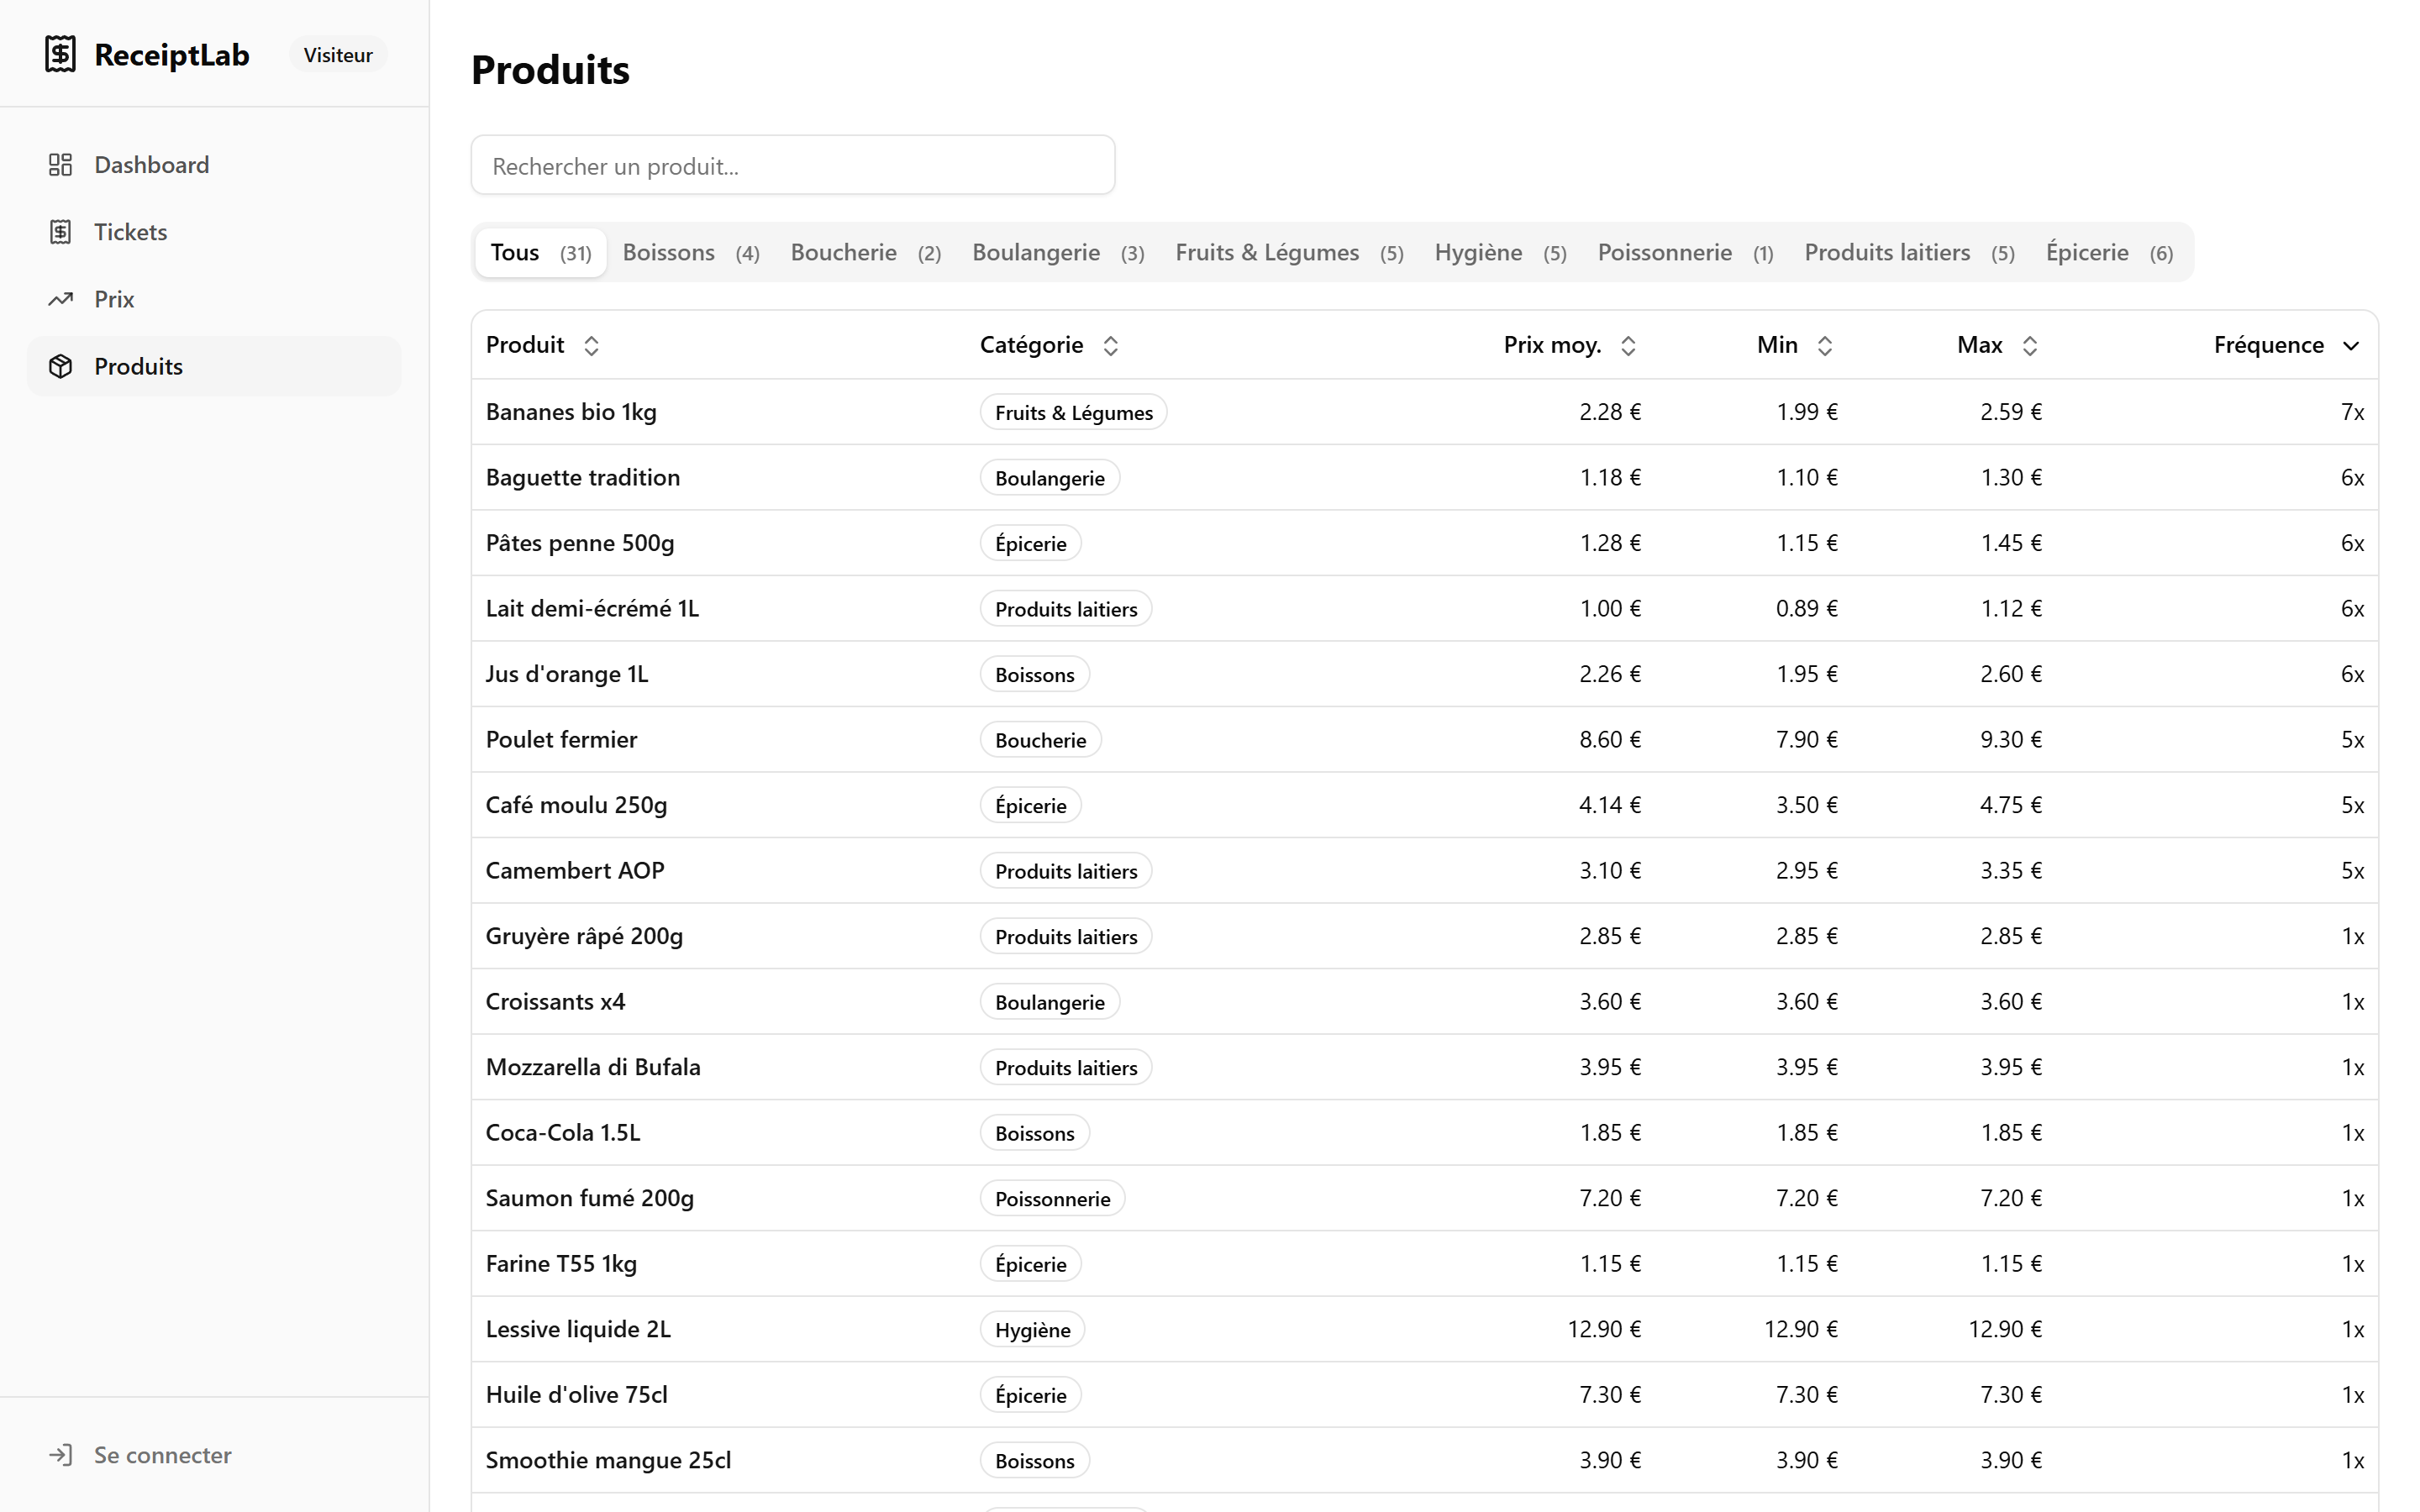
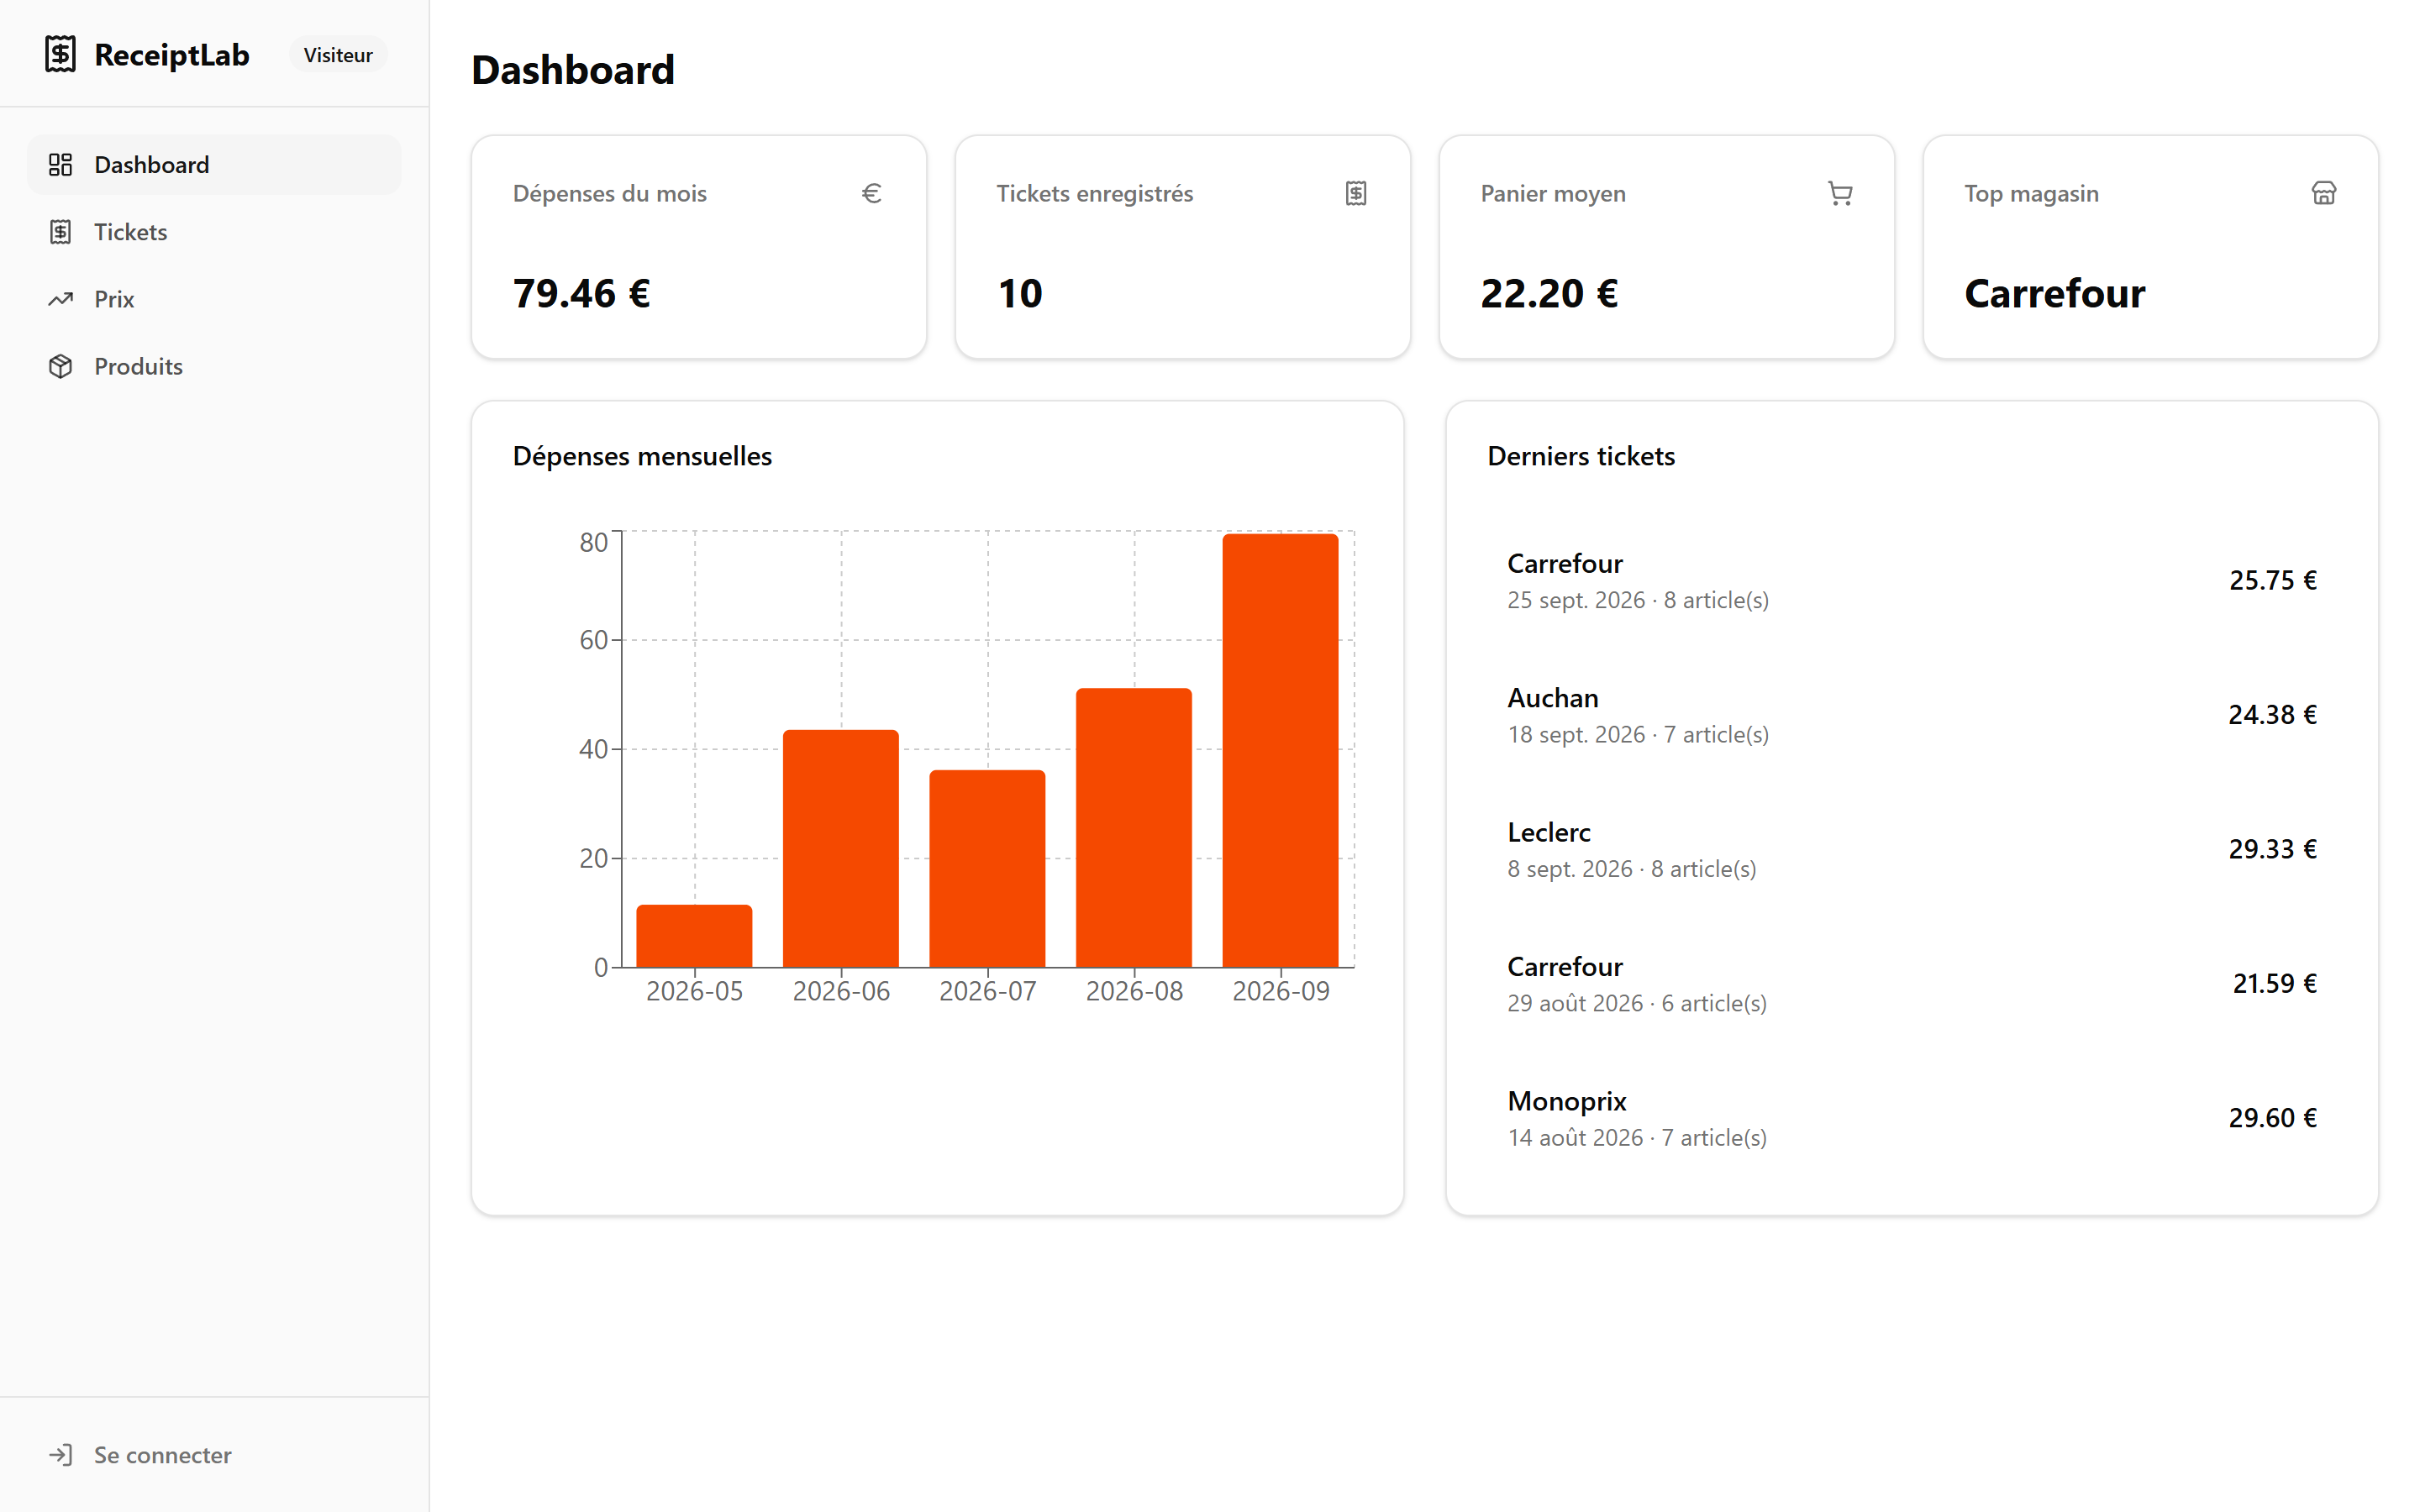
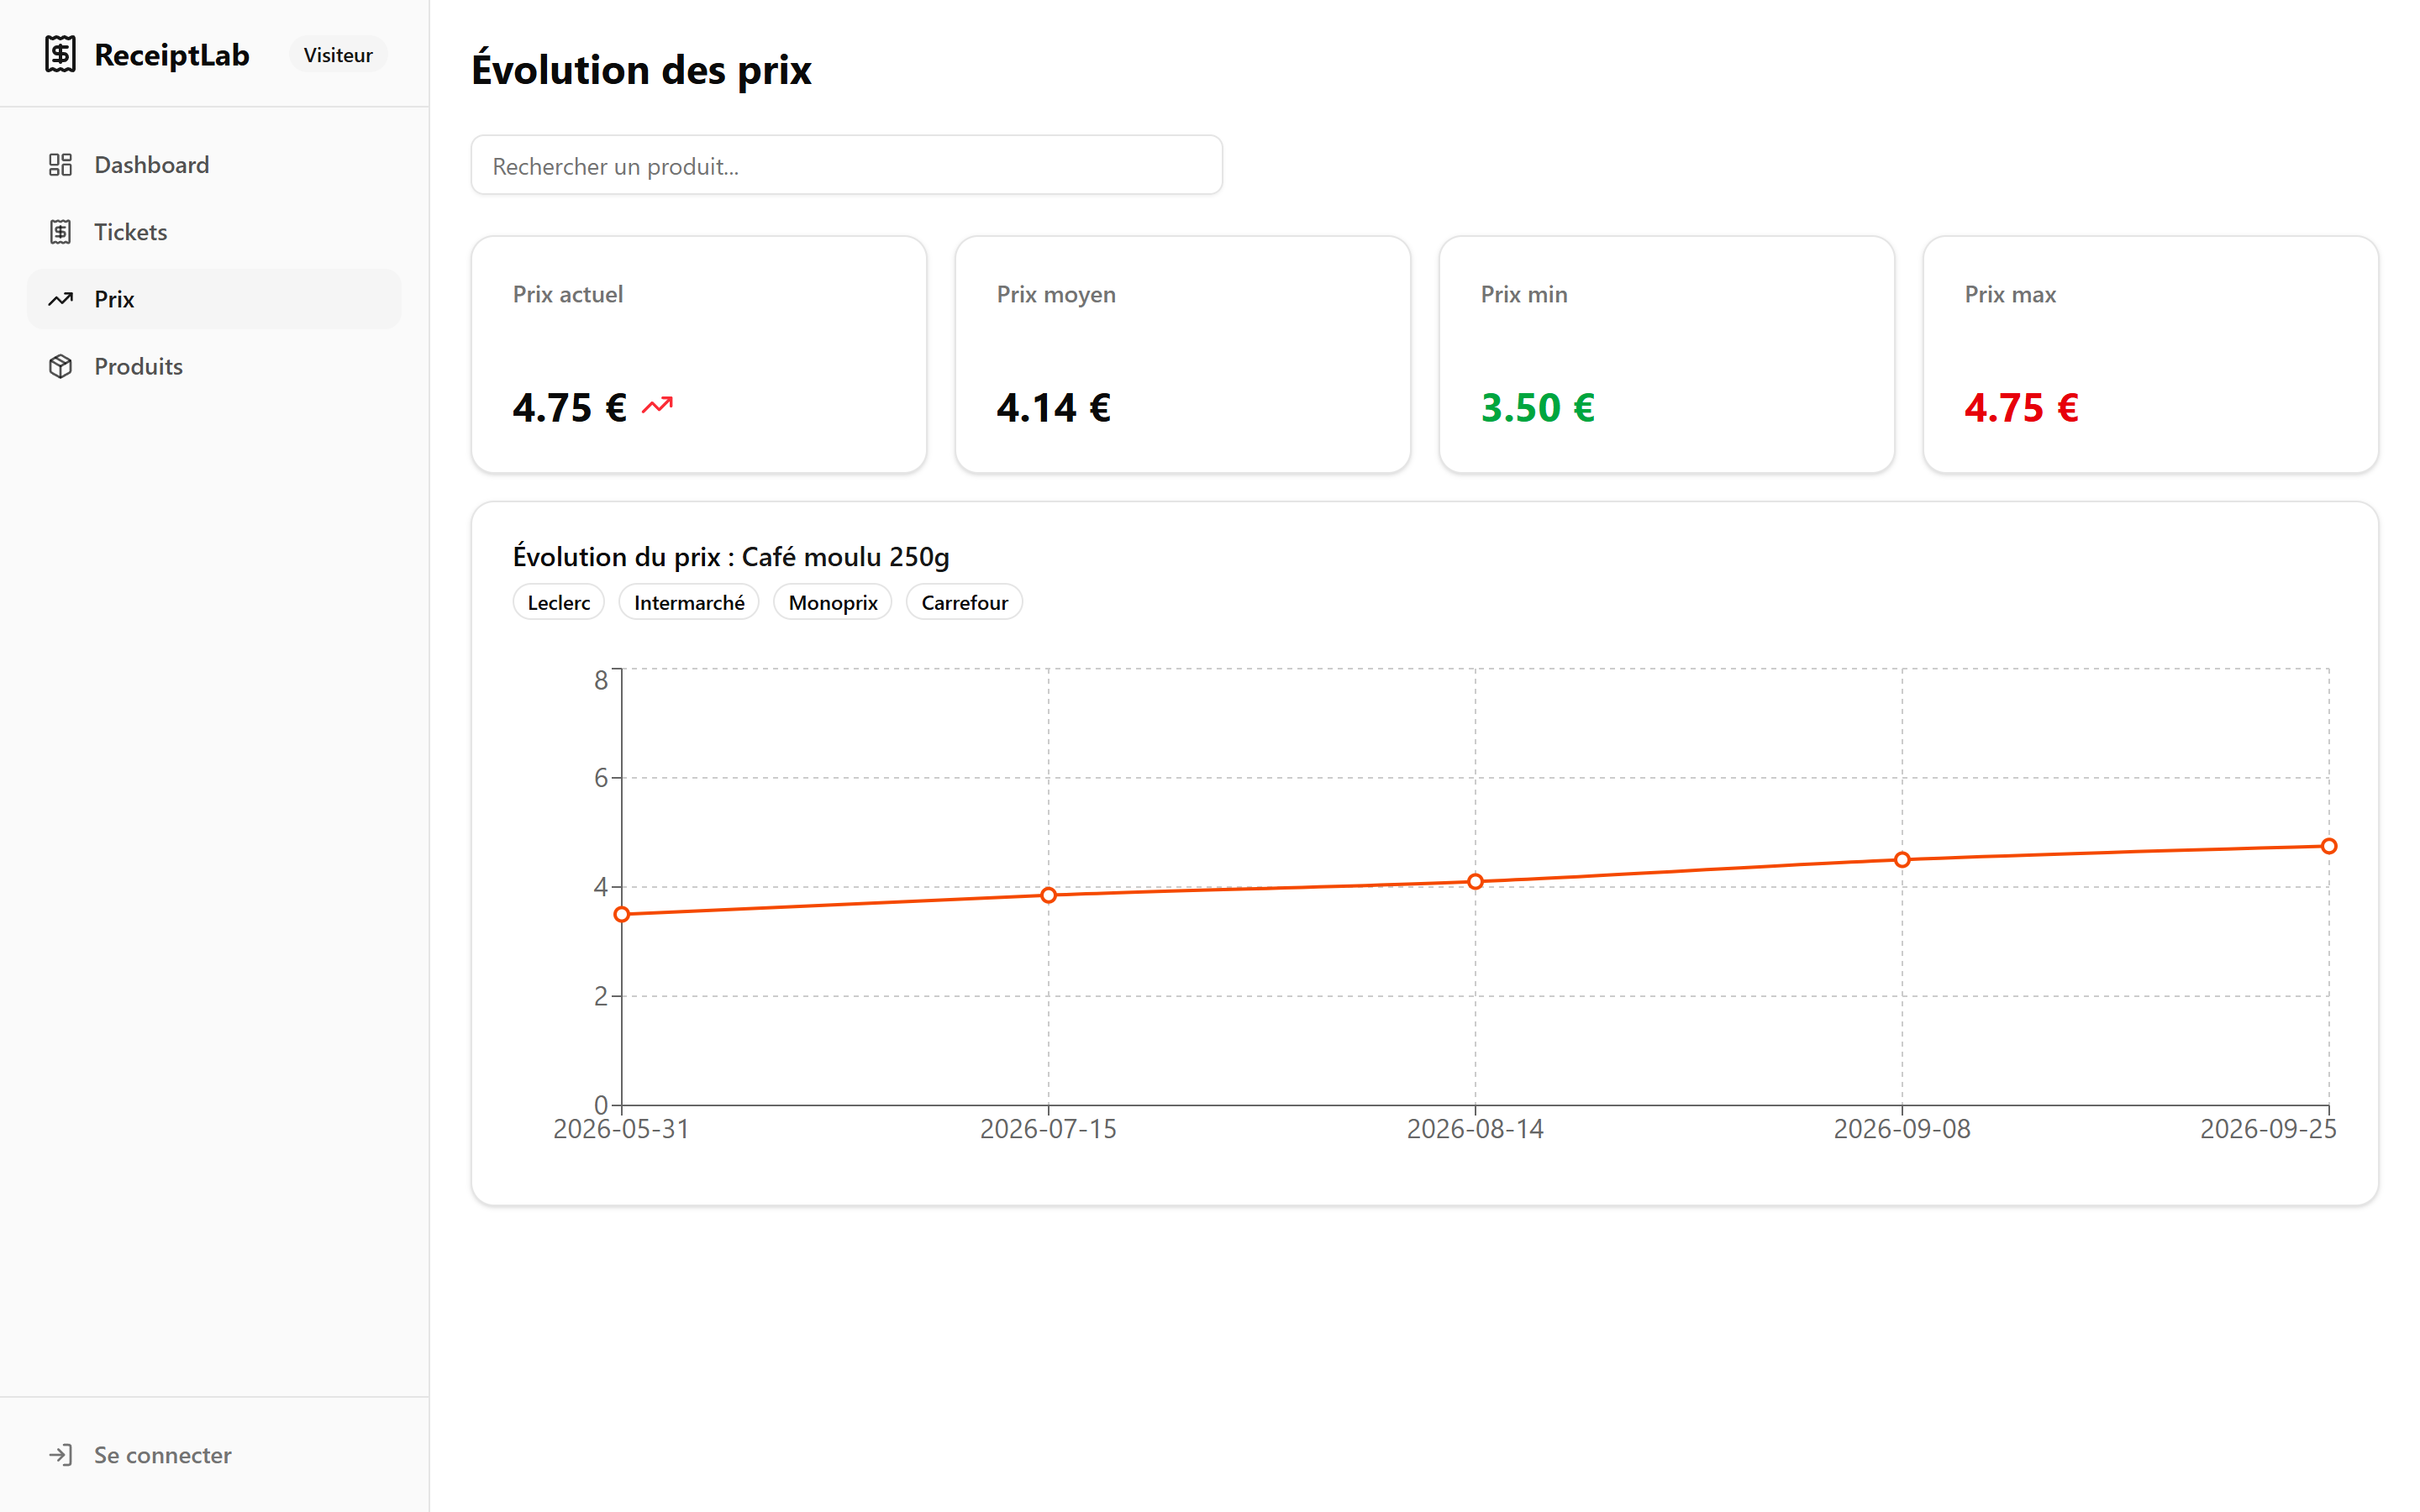
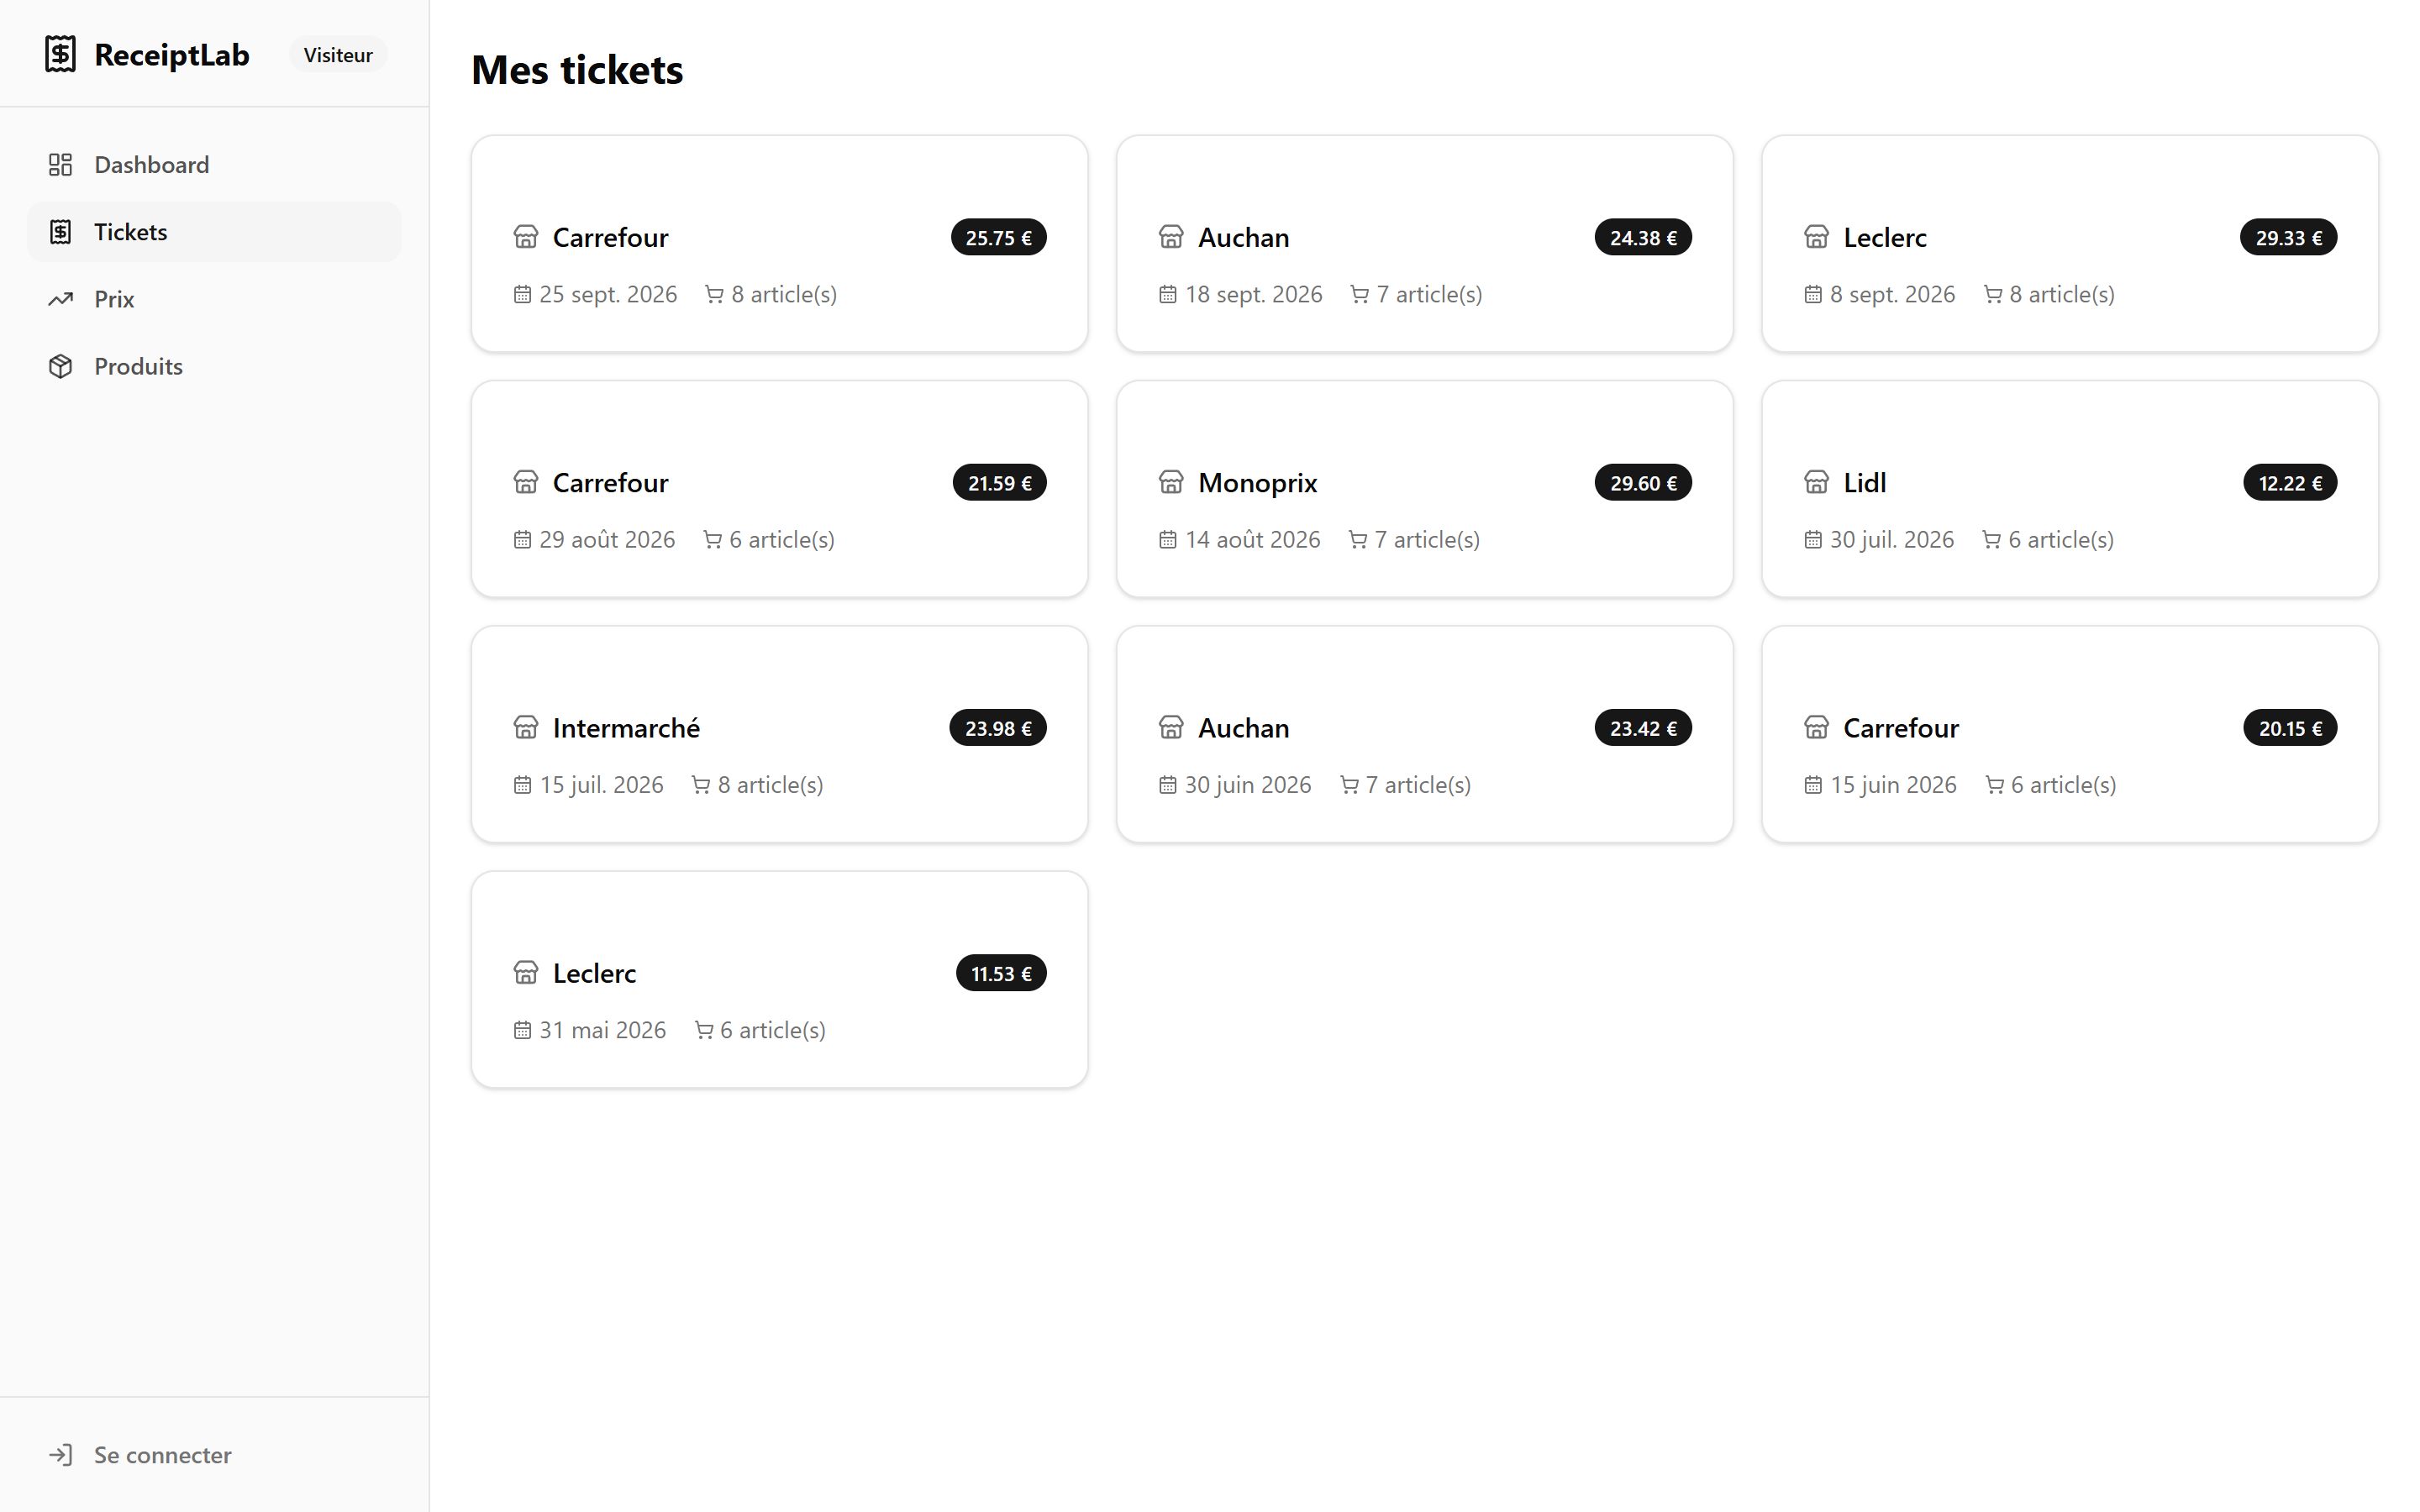
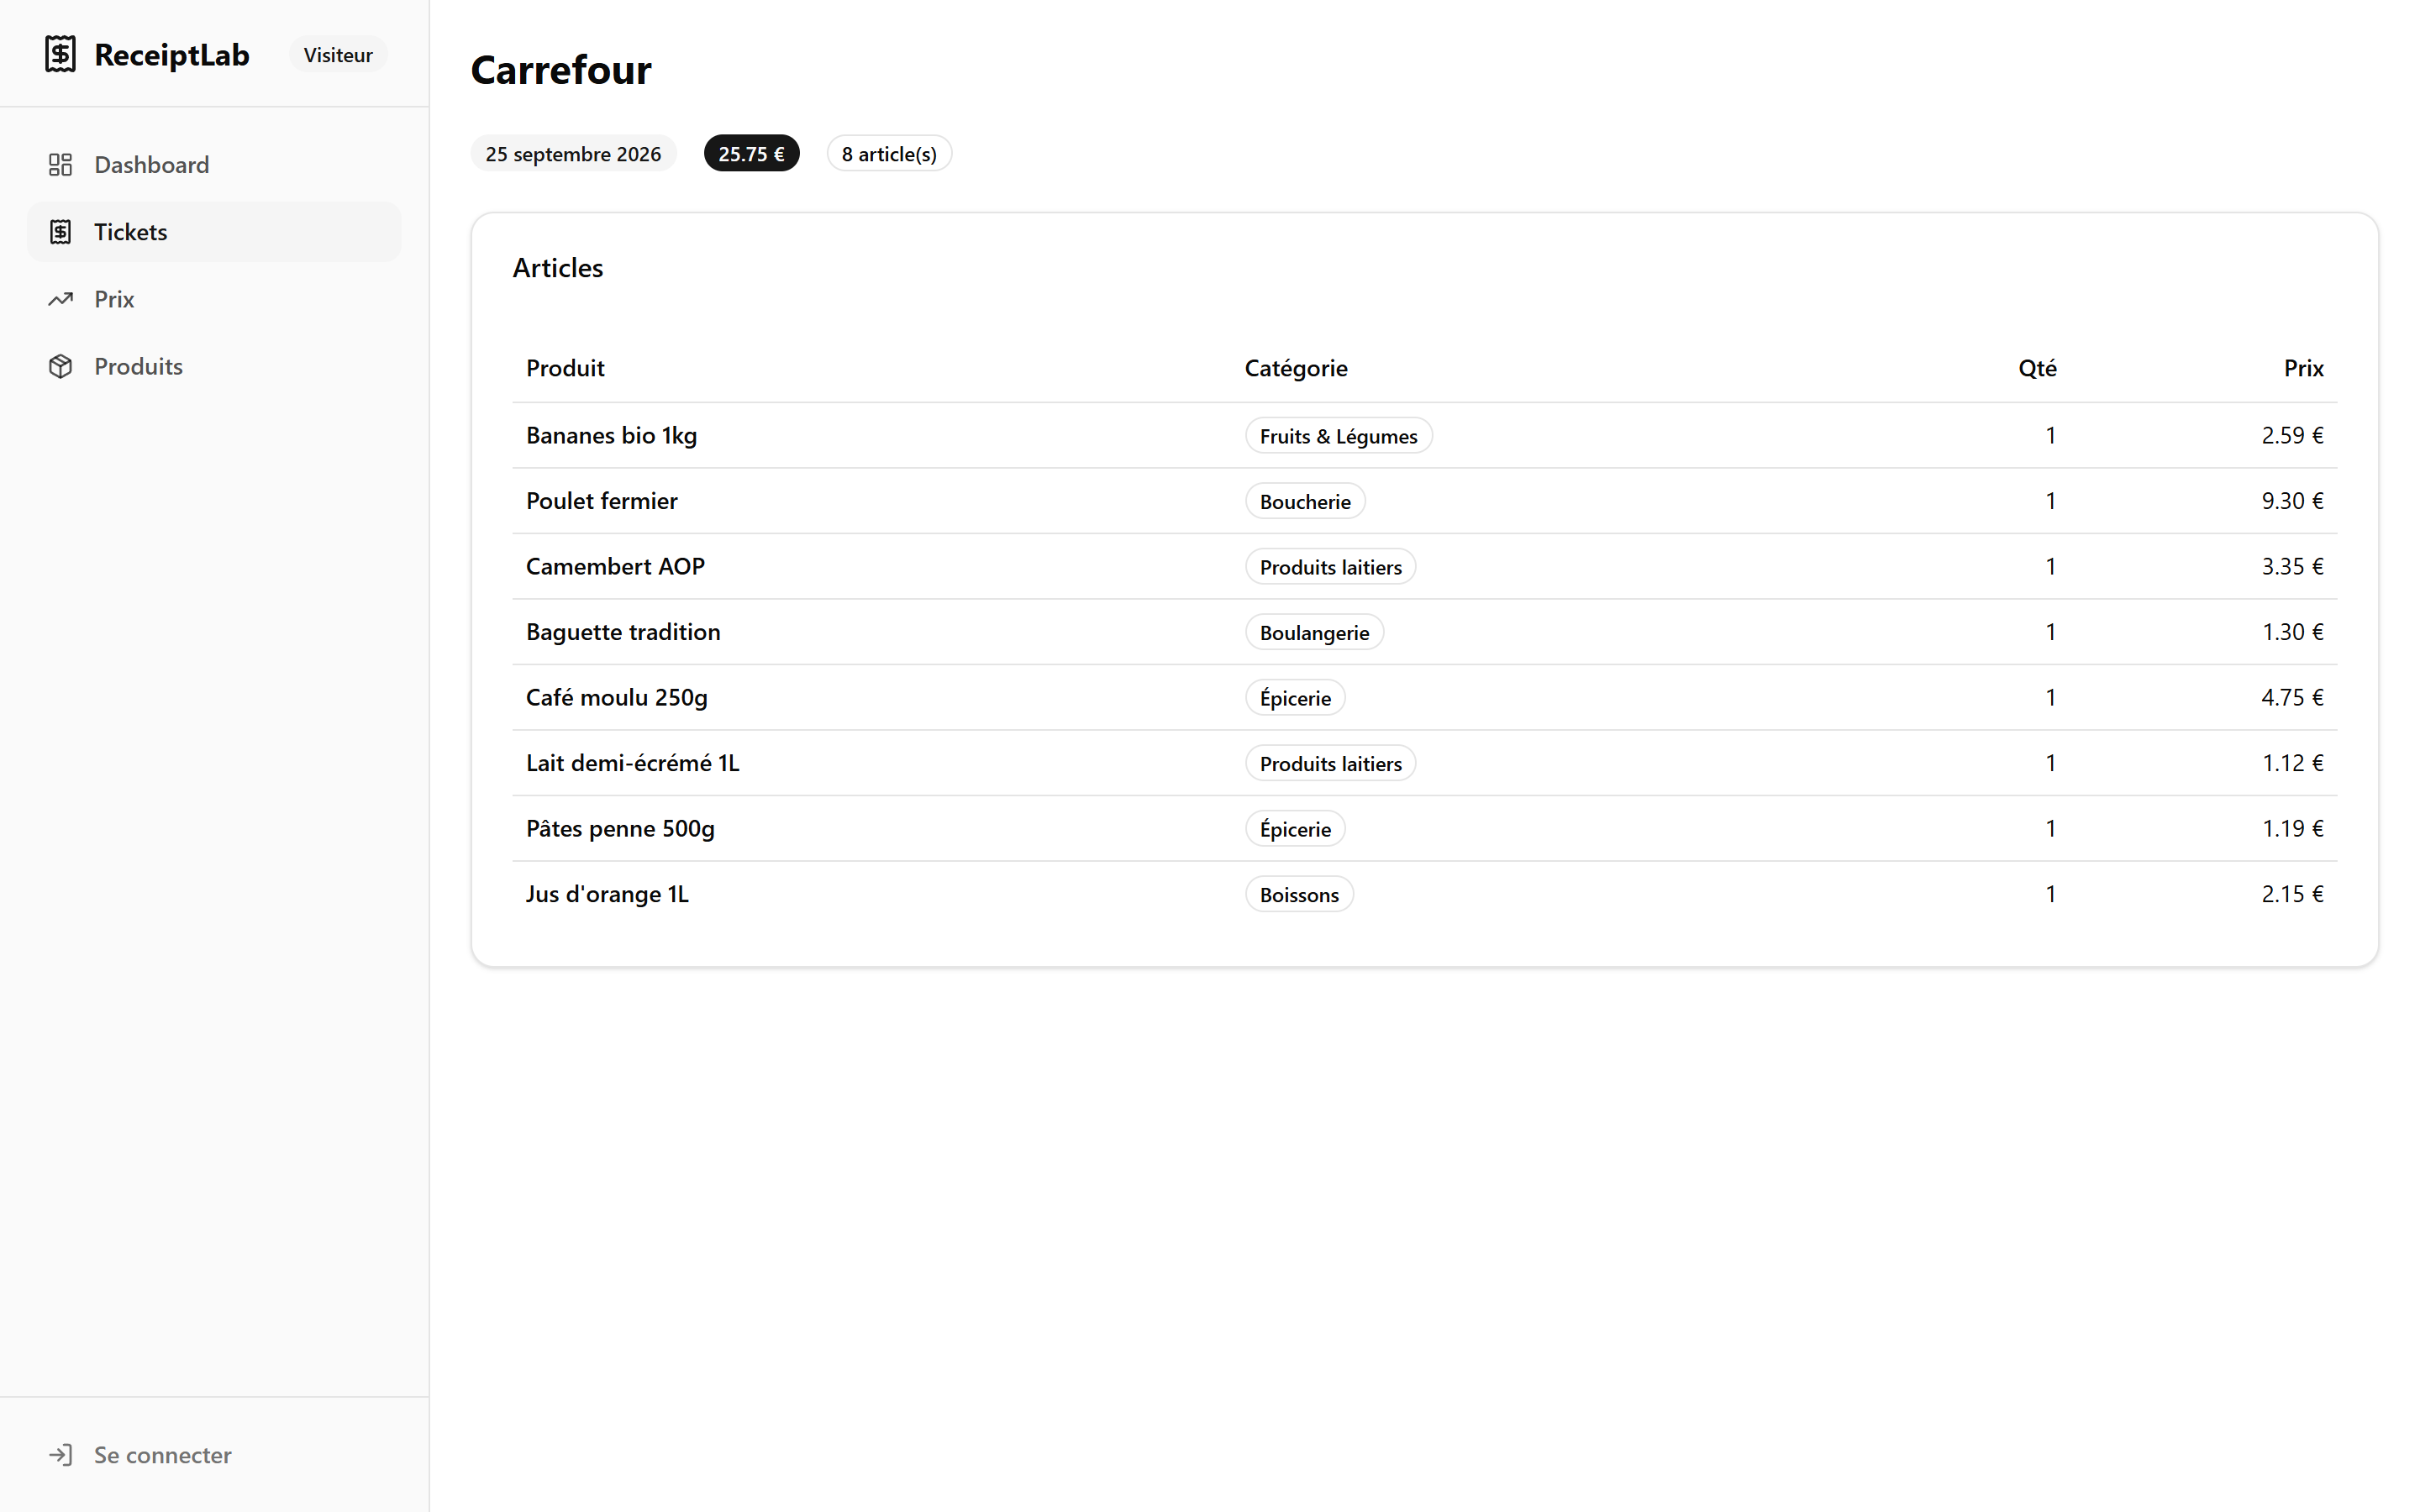
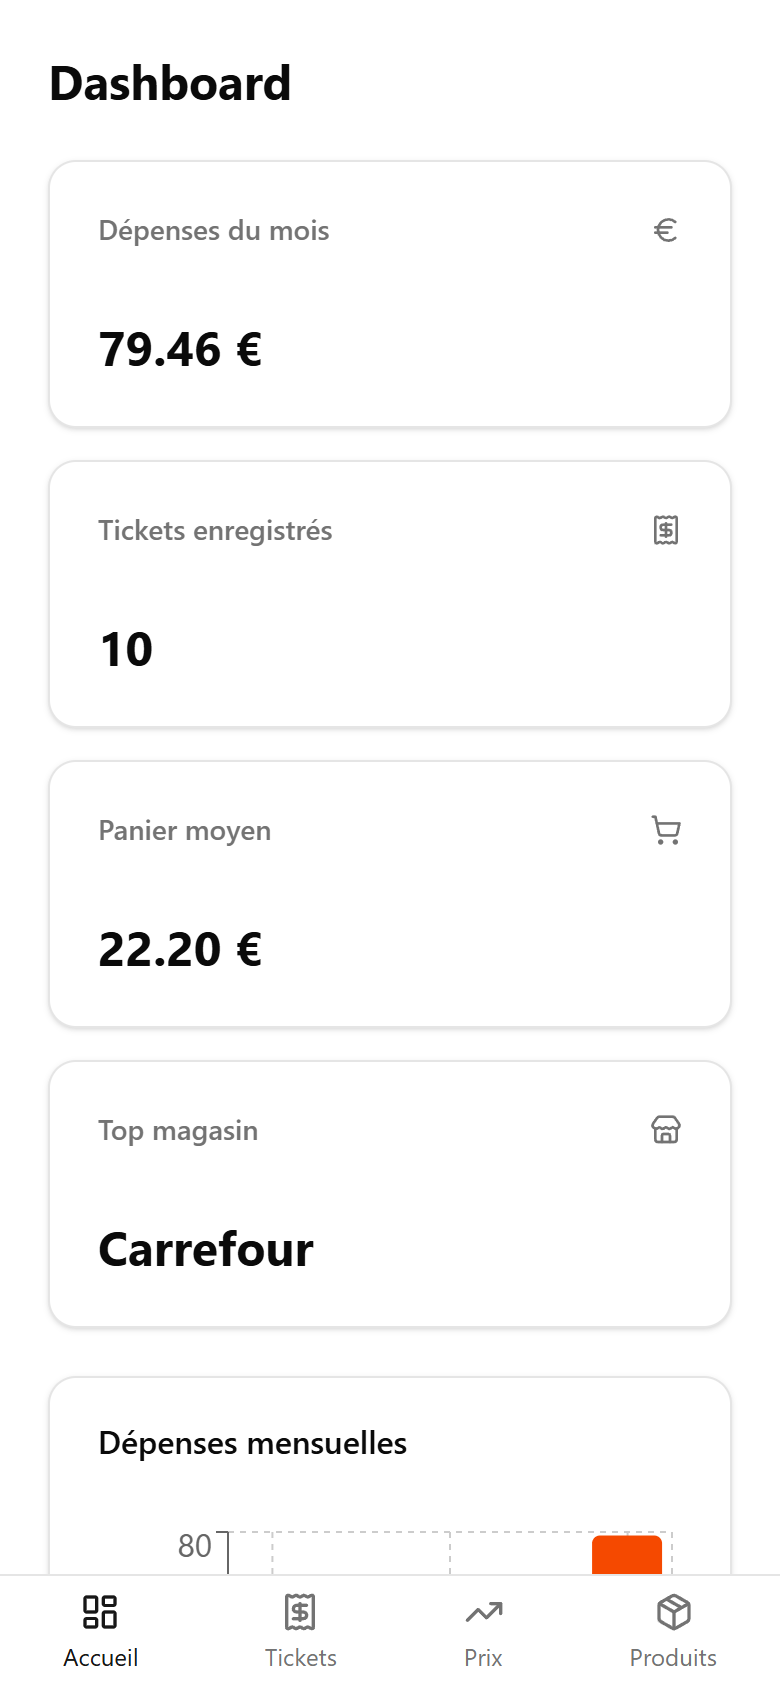
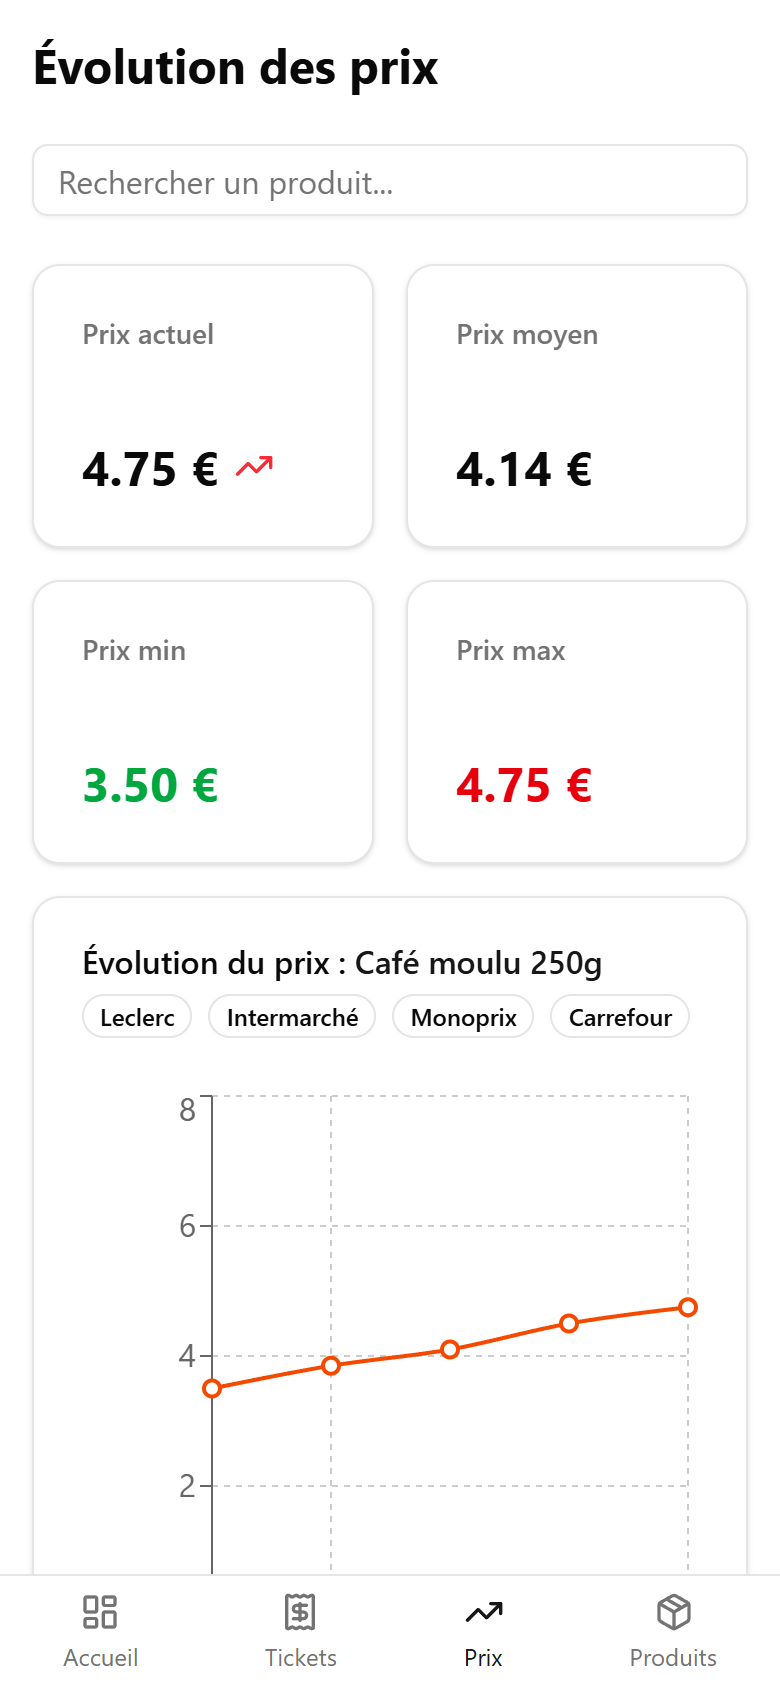
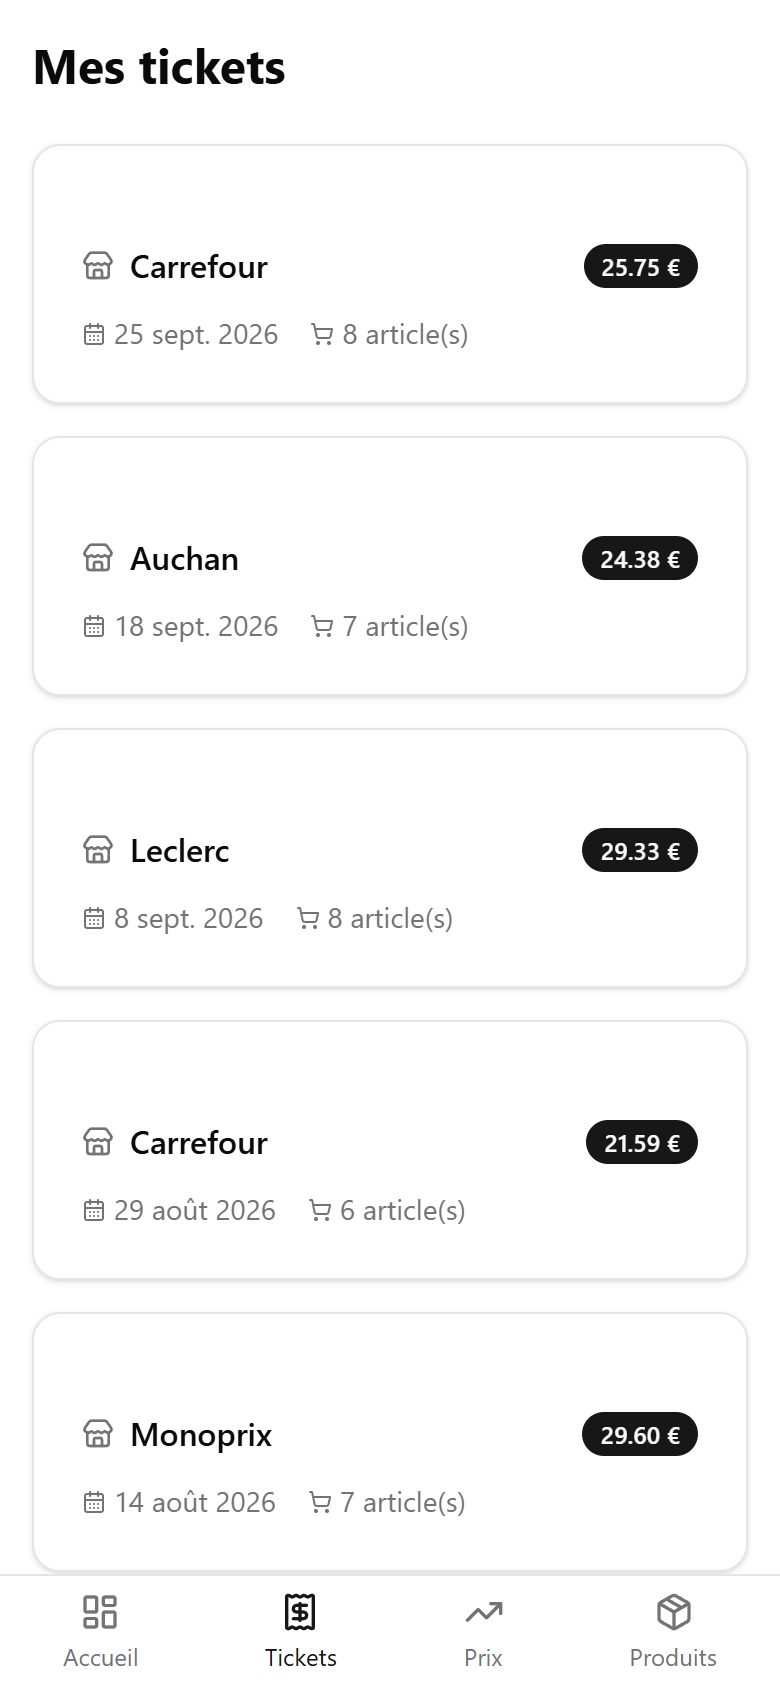
ReceiptLab est une application web qui lit mes tickets de caisse à ma place. Je prends le ticket en photo, une IA en extrait le magasin, la date, chaque produit et son prix, puis l'application range tout ça et me montre combien je dépense et comment le prix de chaque produit évolue dans le temps. Elle est construite avec Next.js 16, React 19 et TypeScript, stylée avec Tailwind CSS 4 et shadcn/ui, s'appuie sur une base Neon Postgres pilotée par Drizzle ORM, et tourne sur Vercel. La lecture des tickets, elle, est confiée à une IA que j'héberge moi-même. Tout le monde a l'impression que « tout augmente », mais très peu de gens peuvent dire de combien le prix de leur paquet de café ou de leur litre de lait a bougé en six mois. L'information existe pourtant, imprimée sur chaque ticket de caisse… qui finit à la poubelle. Les applications de budget classiques demandent de tout saisir à la main, ou se branchent sur le compte bancaire et ne voient qu'un montant global, sans le détail des produits. Je voulais l'inverse, avoir le détail ligne par ligne sans rien taper. D'où l'idée de ReceiptLab. On photographie le ticket, et c'est tout. Concrètement, tout commence par une ou plusieurs photos d'un même ticket, puisque les tickets longs ne tiennent pas toujours sur une seule image. L'IA renvoie alors le magasin, la date, le total et la liste des articles avec leur prix, leur quantité et une catégorie. Rien n'est enregistré sans mon accord. Le résultat s'affiche d'abord dans un éditeur où je peux corriger une ligne mal lue avant de valider. Une fois les tickets enregistrés, l'application les exploite de plusieurs façons. Le tableau de bord résume les dépenses du mois, le panier moyen et le magasin le plus fréquenté, avec un graphique des dépenses mois par mois. Une page recense tous les produits achetés avec leur prix moyen et leur catégorie. Et la page que je préfère trace la courbe d'évolution du prix d'un produit dans le temps, avec son minimum, son maximum et sa moyenne. C'est là qu'on voit, chiffres à l'appui, son paquet de café passer de 3,50 € à 4,75 €. Côté technique, j'ai choisi Next.js avec l'App Router parce qu'il me permet de réunir l'interface et les routes API dans un seul projet, et de lire la base directement depuis des Server Components. TypeScript assure le typage de bout en bout, et Zod valide tout ce qui entre dans l'application, qu'il s'agisse des données envoyées par le navigateur ou des réponses de l'IA. Pour l'interface, shadcn/ui me donne des composants accessibles dont je garde la maîtrise dans le code, et Recharts s'occupe des graphiques. Les données vivent dans Neon, un Postgres serverless, avec Drizzle ORM pour un schéma typé. L'authentification repose sur Better Auth, et chaque push sur la branche principale est déployé automatiquement par Vercel. Quand une photo arrive, la route d'analyse commence par vérifier que l'utilisateur est connecté, qu'il n'envoie pas trop de requêtes et que les images ont une taille et un format raisonnables. Les images partent ensuite vers un modèle de vision, accompagnées d'un prompt qui impose une réponse en JSON strict et décrit les particularités des tickets français. Il faut par exemple rattacher les remises à l'article concerné plutôt que d'en faire une ligne à part, ignorer la TVA et les numéros de carte, rendre lisibles des abréviations comme « CAFE MOUL. ARAB 250G » et ranger chaque produit dans l'une des neuf catégories prévues. Je ne fais pas aveuglément confiance à la réponse de l'IA, et plusieurs garde-fous prennent le relais. Le nom du magasin est comparé à une quarantaine d'enseignes connues grâce à la distance de Levenshtein, pour qu'une lecture approximative comme « CARREF0UR MARKET » soit bien rattachée à Carrefour. Avant l'enregistrement, l'application vérifie aussi qu'aucun ticket avec la même date et le même total n'existe déjà, sans tenir compte du nom du magasin, justement parce qu'il est parfois mal lu. Enfin, si le service d'IA ne répond pas, l'application bascule sur Tesseract.js, un OCR qui tourne directement dans le navigateur, complété par un parseur maison. Le chantier le plus marquant a été le passage à une IA auto-hébergée. La toute première version utilisait Tesseract seul, ce qui suffisait pour lire du texte mais beaucoup moins pour comprendre la structure d'un ticket. Je suis ensuite passé à Google Gemini, et la qualité d'extraction a fait un bond. Mais en quelques semaines, entre les quotas de l'offre gratuite et les modèles dépréciés, j'ai dû changer de modèle plusieurs fois. J'ai donc fini par brancher ReceiptLab sur hub-ia, une passerelle que j'ai montée pour mes propres projets. L'application appelle une API sur un VPS, qui relaie la demande par un réseau privé Tailscale jusqu'à mon PC équipé d'une carte graphique, où Ollama fait tourner un modèle de vision open source. Comme ce PC n'est réveillé qu'à la demande, l'application doit patienter pendant son démarrage, relancer la requête si besoin et respecter des délais bien calibrés. En échange, je ne dépends plus d'aucun quota externe, et les photos de mes tickets ne partent chez aucun fournisseur tiers. Un autre problème est apparu avec l'usage. D'un magasin à l'autre, le même produit ne porte pas le même nom, et « Lait demi-écrémé 1L », « LAIT 1/2 ECR. » et « Lait demi écrémé Lactel » finissaient par avoir chacun leur propre courbe de prix. Pour les regrouper, j'ai d'abord confié tout le catalogue à l'IA en un seul appel, mais dès que la liste grossissait, la fonction dépassait la limite de 300 secondes imposée par Vercel. La solution a été de faire le gros du travail avant même d'appeler l'IA. L'application normalise les noms, les compare avec la distance de Levenshtein et une similarité de Jaccard sur les mots, puis forme des groupes grâce à un algorithme Union-Find. Seuls ces groupes candidats sont envoyés à l'IA pour confirmation, en un appel court. Dans l'interface, chaque regroupement proposé peut ensuite être accepté ou refusé un par un. L'IA propose, l'utilisateur décide. Enfin, je voulais pouvoir montrer le projet sans l'ouvrir à tous les vents, puisque chaque scan consomme du calcul. Un mode visiteur permet donc de parcourir l'application en lecture seule, sur un compte de démonstration rempli de données réalistes où certains prix montent, d'autres baissent ou fluctuent. Les inscriptions doivent être validées par un administrateur, chaque utilisateur dispose de 50 scans par mois, et les routes les plus coûteuses sont protégées contre les abus. S'y ajoutent des en-têtes de sécurité, des limites sur la taille et le format des images, et un audit régulier des dépendances. Comme on scanne le plus souvent son ticket en sortant du magasin, l'interface est entièrement pensée pour le mobile, avec une navigation dédiée sur petit écran. Ce projet m'a surtout appris que l'IA ne fait pas tout. La fiabilité vient autant des garde-fous construits autour d'elle, la validation des données, les algorithmes de similarité et la relecture par l'utilisateur, que du modèle lui-même. Et j'ai mesuré ce que coûte la maîtrise de sa propre infrastructure. L'IA auto-hébergée m'a demandé plus de travail, mais elle m'a rendu indépendant, aussi bien sur les coûts que sur les données. Pour la suite, j'aimerais ajouter des alertes quand un produit habituel augmente fortement, comparer le prix d'un même produit d'une enseigne à l'autre et permettre l'export des données.
Gallery9 images